日常做开发、写脚本或者搭建一些自动化流程时,我经常会需要调用一些轻量、响应迅速的模型来做快速文本清洗、结构化抽取以及小规模代码生成。对于重度任务,大参数旗舰模型自然不可替代;但在跑批处理、即时补全或构建多 Agent 流水线时,响应延迟和调用成本往往才是决定体验的核心。
最近为了整合手头零散的模型调用需求,我尝试找一些接入更简单、模型选择更集中的中转服务。在这期间接触到了 VibeShelf,并用 GLM-5.3 Flash 跑了几次实际请求。这篇文章就记录一下我最近的使用感受、看到的调用数据,以及使用这类服务时需要注意的事项。
从注册到第一次调用:我实际走了一遍
如果你只是想先试一下,不需要一开始就购买较大的额度。我这次用一个新账号走完了注册、兑换测试额度、创建密钥和第一次请求,流程大致如下。
1. 注册账号
打开 VibeShelf 登录页,点击“注册”,填写邮箱和密码后创建账号。注册完成后会进入控制台。页面上的登录和注册入口比较直观,第一次使用建议单独为这个服务设置一个强密码。

图 4:注册页入口。正式发布时可以换成单独截取的登录页图片,避免展示浏览器标签和个人账号信息。
2. 先用兑换码拿测试额度
登录后进入左侧的“兑换”页面,把兑换码粘贴到输入框,点击“兑换”。我这次的测试结果是余额增加 ¥5.00,并且在“最近活动”里留下了一条兑换记录。

图 5:兑换成功后显示余额和到账金额。兑换码通常只能使用一次,公开发布前请确认手里的测试码仍然有效。
这一步适合用来验证接口、模型和自己的调用方式。文章发布时不建议直接放已经使用过的一次性兑换码,最好换成一个仍可用、额度和有效期已经确认的测试码。
3. 创建 API Key
进入左侧“API 密钥”,点击“创建密钥”,填写一个容易识别的名称,再选择允许使用的模型分组。创建完成后,完整密钥通常只会在创建时显示一次,应该立刻复制到密码管理器或本地环境变量中。

图 6:API Key 管理页面。截图只保留了掩码后的 Key,完整密钥不要放进博客、截图或公开仓库。
创建密钥时可以按应用分别创建,这样之后查看用量、停用密钥或排查问题会更方便。API 端点可以在页面上直接复制;本文实测使用的是:
https://api.vibeshelf.dev/v1
图 7:接入文档列出了 OpenAI 兼容接口、服务地址和最小测试请求。
4. 用 cURL 发出第一条请求
把完整密钥放进环境变量,再发送一条最小请求。这样做可以避免把密钥直接写进 shell 历史、代码仓库或文章正文:
export VIBESHELF_API_KEY="你的 API Key"

curl https://api.vibeshelf.dev/v1/chat/completions \
  -H "Authorization: Bearer ${VIBESHELF_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {"role": "user", "content": "请用一句话说明 API 调用成功。"}
    ],
    "temperature": 0.2,
    "max_tokens": 80
  }'
成功时会返回标准的聊天完成 JSON,重点检查 HTTP 状态码、choices[0].message.content 和 usage 字段即可:
{
  "choices": [
    {
      "message": {
        "role": "assistant",
        "content": "API 调用成功,请求已正确处理并返回预期结果。"
      }
    }
  ],
  "model": "glm-5-3-flash-260828"
}
我实际调用的就是这个接口路径和模型参数,服务返回了正常的聊天完成结果。响应里的 model 字段返回了一个带版本号的模型标识,这是服务端实际路由后的名称;日常配置时仍以模型广场和文档中可选的模型 ID 为准。
5. 用 Python SDK 接入已有项目
如果项目已经使用 OpenAI 兼容 SDK,可以只把端点和密钥换成自己的配置:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["VIBESHELF_API_KEY"],
    base_url="https://api.vibeshelf.dev/v1",
)

response = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "请用一句话说明 API 调用成功。"}
    ],
    temperature=0.2,
    max_tokens=80,
)

print(response.choices[0].message.content)
如果你的项目使用的是其他 SDK,先确认它支持 OpenAI 风格的 chat/completions 请求,并根据官方文档调整参数。不要默认所有高级参数、工具调用和多模态字段都完全兼容。
6. 在控制台查看用量
请求成功后,打开“使用记录”就能看到模型、Token、端点、费用和耗时。我这次的单次测试记录是:输入 23 tokens、输出 508 tokens、总计 531 tokens,实际消费 ¥0.0007,平均耗时 13.06 秒,端点为 /v1/chat/completions。

图 8:控制台用量概览。这里的数字只代表这一次测试请求,不代表长期平均成本或速度。

图 9:使用记录明细。公开截图前要遮盖 IP、账号、完整 API Key 和其他可识别信息。
7. 购买额度入口只需要看懂页面
如果测试额度用完,可以从左侧“充值/订阅”进入充值页面,选择金额和支付方式后再确认。本文只展示入口,不进行真实购买;实际支付前应再次核对金额、计费方式、余额有效期和退款规则。

图 10:充值页面入口。正式支付前先用兑换额度完成接口验证,会更适合个人开发者。
这套流程适合怎样的使用方式
我自己的建议是:先注册,兑换少量测试额度,创建一个单独的 API Key,发一条最小请求,确认模型 ID、端点和返回格式都符合预期,再决定是否把它接入项目。测试时不要把生产密钥、客户资料或其他敏感 Prompt 直接发给第三方网关,也不要把 API Key 写进 Git 仓库。
如果只想快速体验 GLM-5.3 Flash,cURL 足够完成验证;如果准备接入脚本或应用,再使用 Python SDK,并在本地做好超时、重试、错误处理和余额监控。这样即使后续更换模型或服务,也不会把配置和业务代码绑死在一起。
统一网关与初步上手
对我来说,频繁在不同云服务商后台切 Token、看文档是一件挺消耗精力的事情。初次打开 VibeShelf 的首页,它的产品形态相对清晰:定位为一个统一 AI API 网关。

图 11:VibeShelf 首页界面,展示了统一 API 端点接入与控制台概览。
从首页可见的功能来看,它主要对应了几个开发者普遍关心的需求:
- 统一端点:把服务端点和 API Key 集中到一个入口,减少在不同平台之间反复切换的麻烦。具体接口格式和兼容范围,仍然要以它的文档为准。
- 多模型集中入口:可以在同一个控制台查看已经接入的模型,按任务选择不同模型。
- 用量和计费集中查看:首页强调透明计费和用量管理,模型价格页也把输入、输出、缓存读取分开列出,至少比较价格时更直观。
- 接入路径清楚:首页直接给出了 Base URL、API Key 和模型名的配置示例,适合先用一个小项目验证调用流程。
这种设计让它很适合作为个人开发者、Side Project 快速验证概念的中间层。
GLM-5.3 Flash 实测:几组调用记录与体感
在多模型列表中,我重点试跑了 GLM-5.3 Flash。选择它的原因很简单:我希望找一个响应快、成本容易控制的模型,用来处理日常的文本和代码任务。
需要提前说明的是,网络环境、提示词长度、并发状态和服务器瞬时负载都会影响吞吐速度。以下数据仅代表我个人在 2026-10-03 当天、针对特定 Prompt 进行的抽样记录,不代表服务商的长期性能承诺或 SLA 保障。
在当天的几次调用记录中,后台显示的平均 TPS(Tokens Per Second)分别约为 92.1、95.3、99.1、131.6 和 119.2 tokens/s。这些数字来自我自己的几次请求,提示词长度、输出长度和当时的网络状态都可能影响结果。
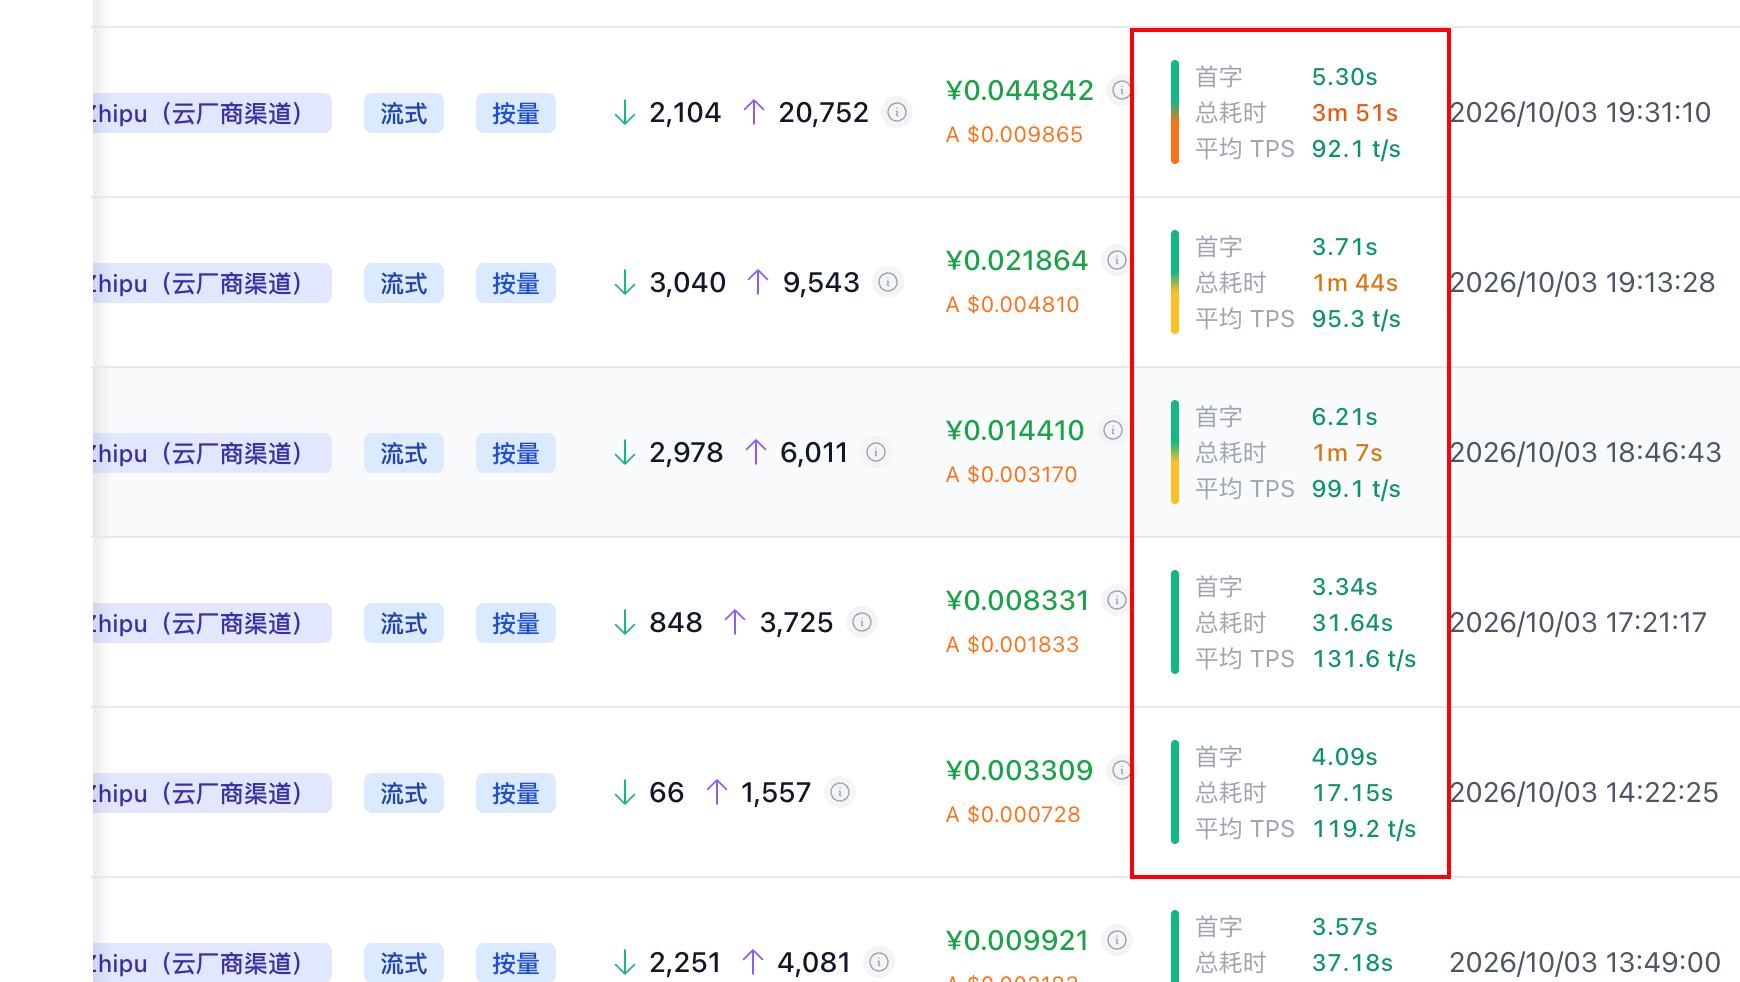
图 12:2026-10-03 部分调用日志详情,展示了上述几次请求的实际 TPS 表现。(提示:截图在公开分享前,建议检查并对个人邮箱、IP 地址以及密钥账号等敏感信息做好打码处理。)
个人体感评价
脱离冰冷的数字,从主观体验来看:
- 吐字流畅度:在我运行几次代码生成任务时,流式输出(Streaming)的打字机效果几乎感觉不到卡顿与停滞,整段 Python 脚本一气呵成。
- 文本处理:我用它处理过一些文本整理、改写和结构化任务,输出速度很快,等待感比较低。
- 首字延迟(TTFT):我没有做毫秒级的 TTFT 测试,所以这里只说主观感受:从发起请求到看到持续输出,整体反馈比较及时。
价格透明度与成本把控
对于个人开发者来说,API 的性价比和计费透明度至关重要。VibeShelf 提供了公开的模型价格页面,列出了支持模型的计费梯度。
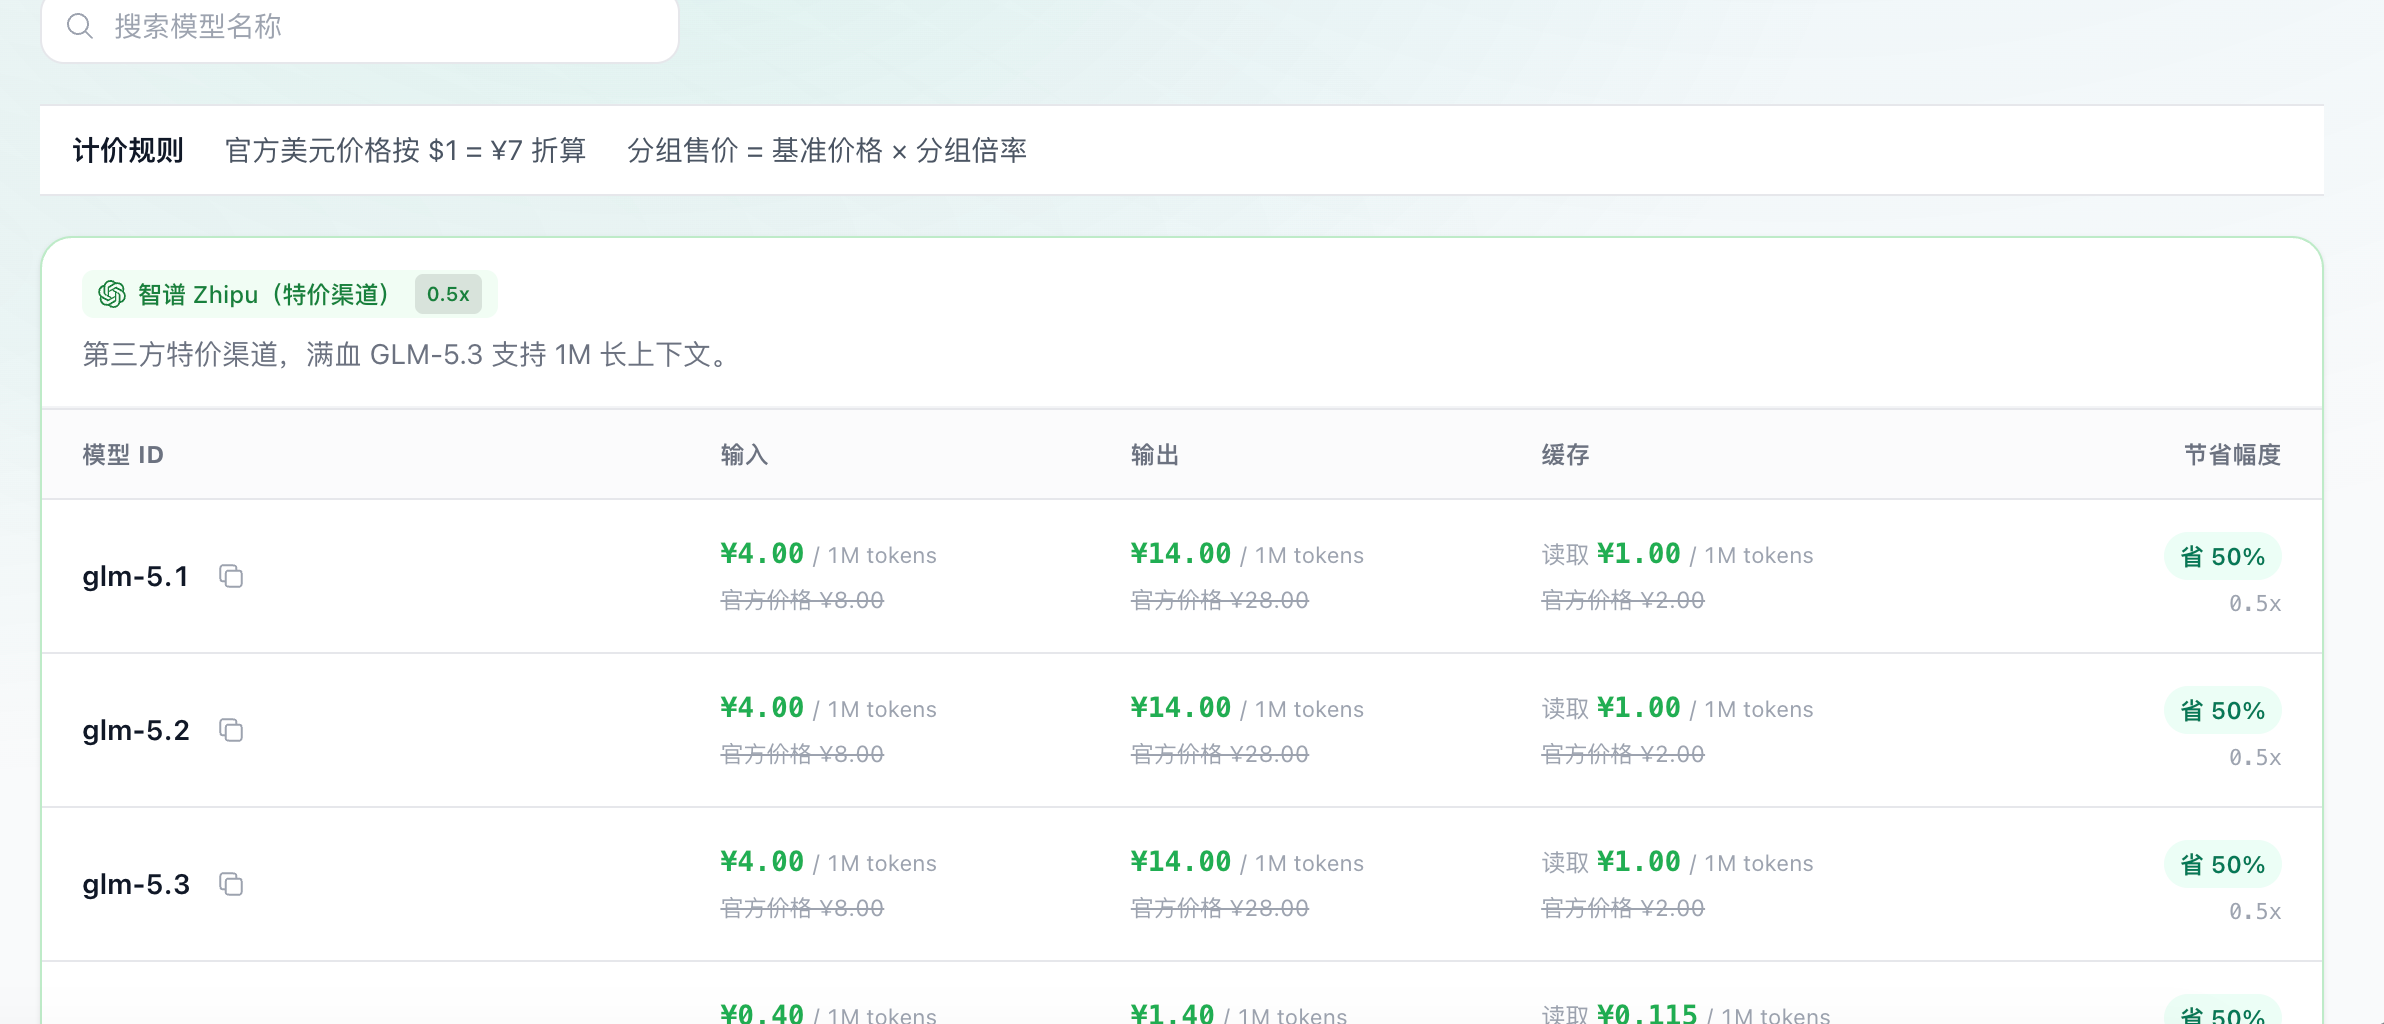
图 13:VibeShelf 模型价格看板,标注了各模型的计费单价。
我比较关注的是价格页有没有把计费口径讲清楚。当前页面把输入、输出和缓存读取分开展示,至少在比较不同模型时,不需要只看一个模糊的“起步价”。具体费用仍然要以登录后的控制台账单和实际调用结果为准,建议先用小额请求验证自己的用量。
第三方 API 中转服务的理性选择与避坑提醒
虽然中转聚合工具使用起来非常顺手,但作为有经验的开发者,必须保持清醒和克制。需要明确的是,此类平台是独立的第三方网关服务,与底层模型提供方(例如智谱官方)并不存在官方背书关系。
在把任何第三方 API 服务接入生产或严肃项目之前,我建议大家一定要关注以下几点:
- 数据隐私与留存策略: 第三方中转通常会对请求进行日志记录以便计费与排错。请仔细阅读平台的服务条款(ToS),明确其对 Prompt 与输出内容的存储周期与隐私承诺。切勿将包含企业机密、个人隐私或强敏感合规要求的数据发送给第三方公共网关。
- 限流机制(Rate Limits): 中转服务一般会根据用户层级或当前集群负载施加并发限制(RPM / TPM)。不要轻信“无限制并发”或“永久不限流”的宣传,生产环境务必做好本地重试降级与容错兜底机制。
- 余额机制与退款条款: 充值前注意看清余额有效期、是否有最低充值门槛以及是否支持退款。建议遵循“随用随充、小额验证”的原则,避免单次预充过多资金。
- 服务稳定性与可用性: 第三方平台受上游网络抖动、链路调度及政策波动影响较大。如果业务对可用性有严苛要求(如 99.9% 以上 SLA),多活备份或官方直连通道依然是更稳妥的选择。
结语
总体体验下来,VibeShelf 作为一款聚合类 AI API 网关,在接入便利性、计费透明度以及核心易用性上做得比较规整。而搭配 GLM-5.3 Flash 在我那几组测试中展现出来的响应速度与输出流畅度,确实很适合用来跑各类高频、轻量的脚本及自动化任务。
如果你也正好在寻找统一的 API 接入层,或者想找个门槛较低的环境测试轻量模型的表现,可以自行前往 VibeShelf 官网 浏览并了解具体细节。按需充值、理性测试,找到最适合自己工作流的工具组合即可。
了解 Hana - 探索有趣的世界 的更多信息
订阅后即可通过电子邮件收到最新文章。


暂无评论