不是把模型装在电脑里就算成功,而是它开始真的能写代码、读需求、做页面。当一台旧电脑可以稳定地完成正则、SQL 和网页生成,本地 AI 就从技术演示变成了可复用的生产力工具。
先说结论:Strata 值得试,但理由不是“它最强”
如果你只想找一个排行榜第一的模型,Strata 可能不是最直接的答案。但如果你关心模型能不能部署到自己的电脑、能不能接入 OpenCode 或编辑器、代码和内部文档能不能留在本地,那么 Strata 是最近值得关注的开源项目。
它的核心叙事很简单:把原本需要服务器级显存的大模型,拆分到一台普通游戏电脑的 GPU、内存、CPU 和 SSD 上运行。项目 README 给出的定位,是在 12GB 以上显存、32GB 以上内存的 Windows 或 Linux 电脑上运行 125B 级别的 Qwen3.8-Flash-Next,并通过 OpenAI 兼容接口接入自己的工具链。
我的测试:旧电脑也能到 20+ tok/s
12GB
6C / 12T
DDR4
tok/s
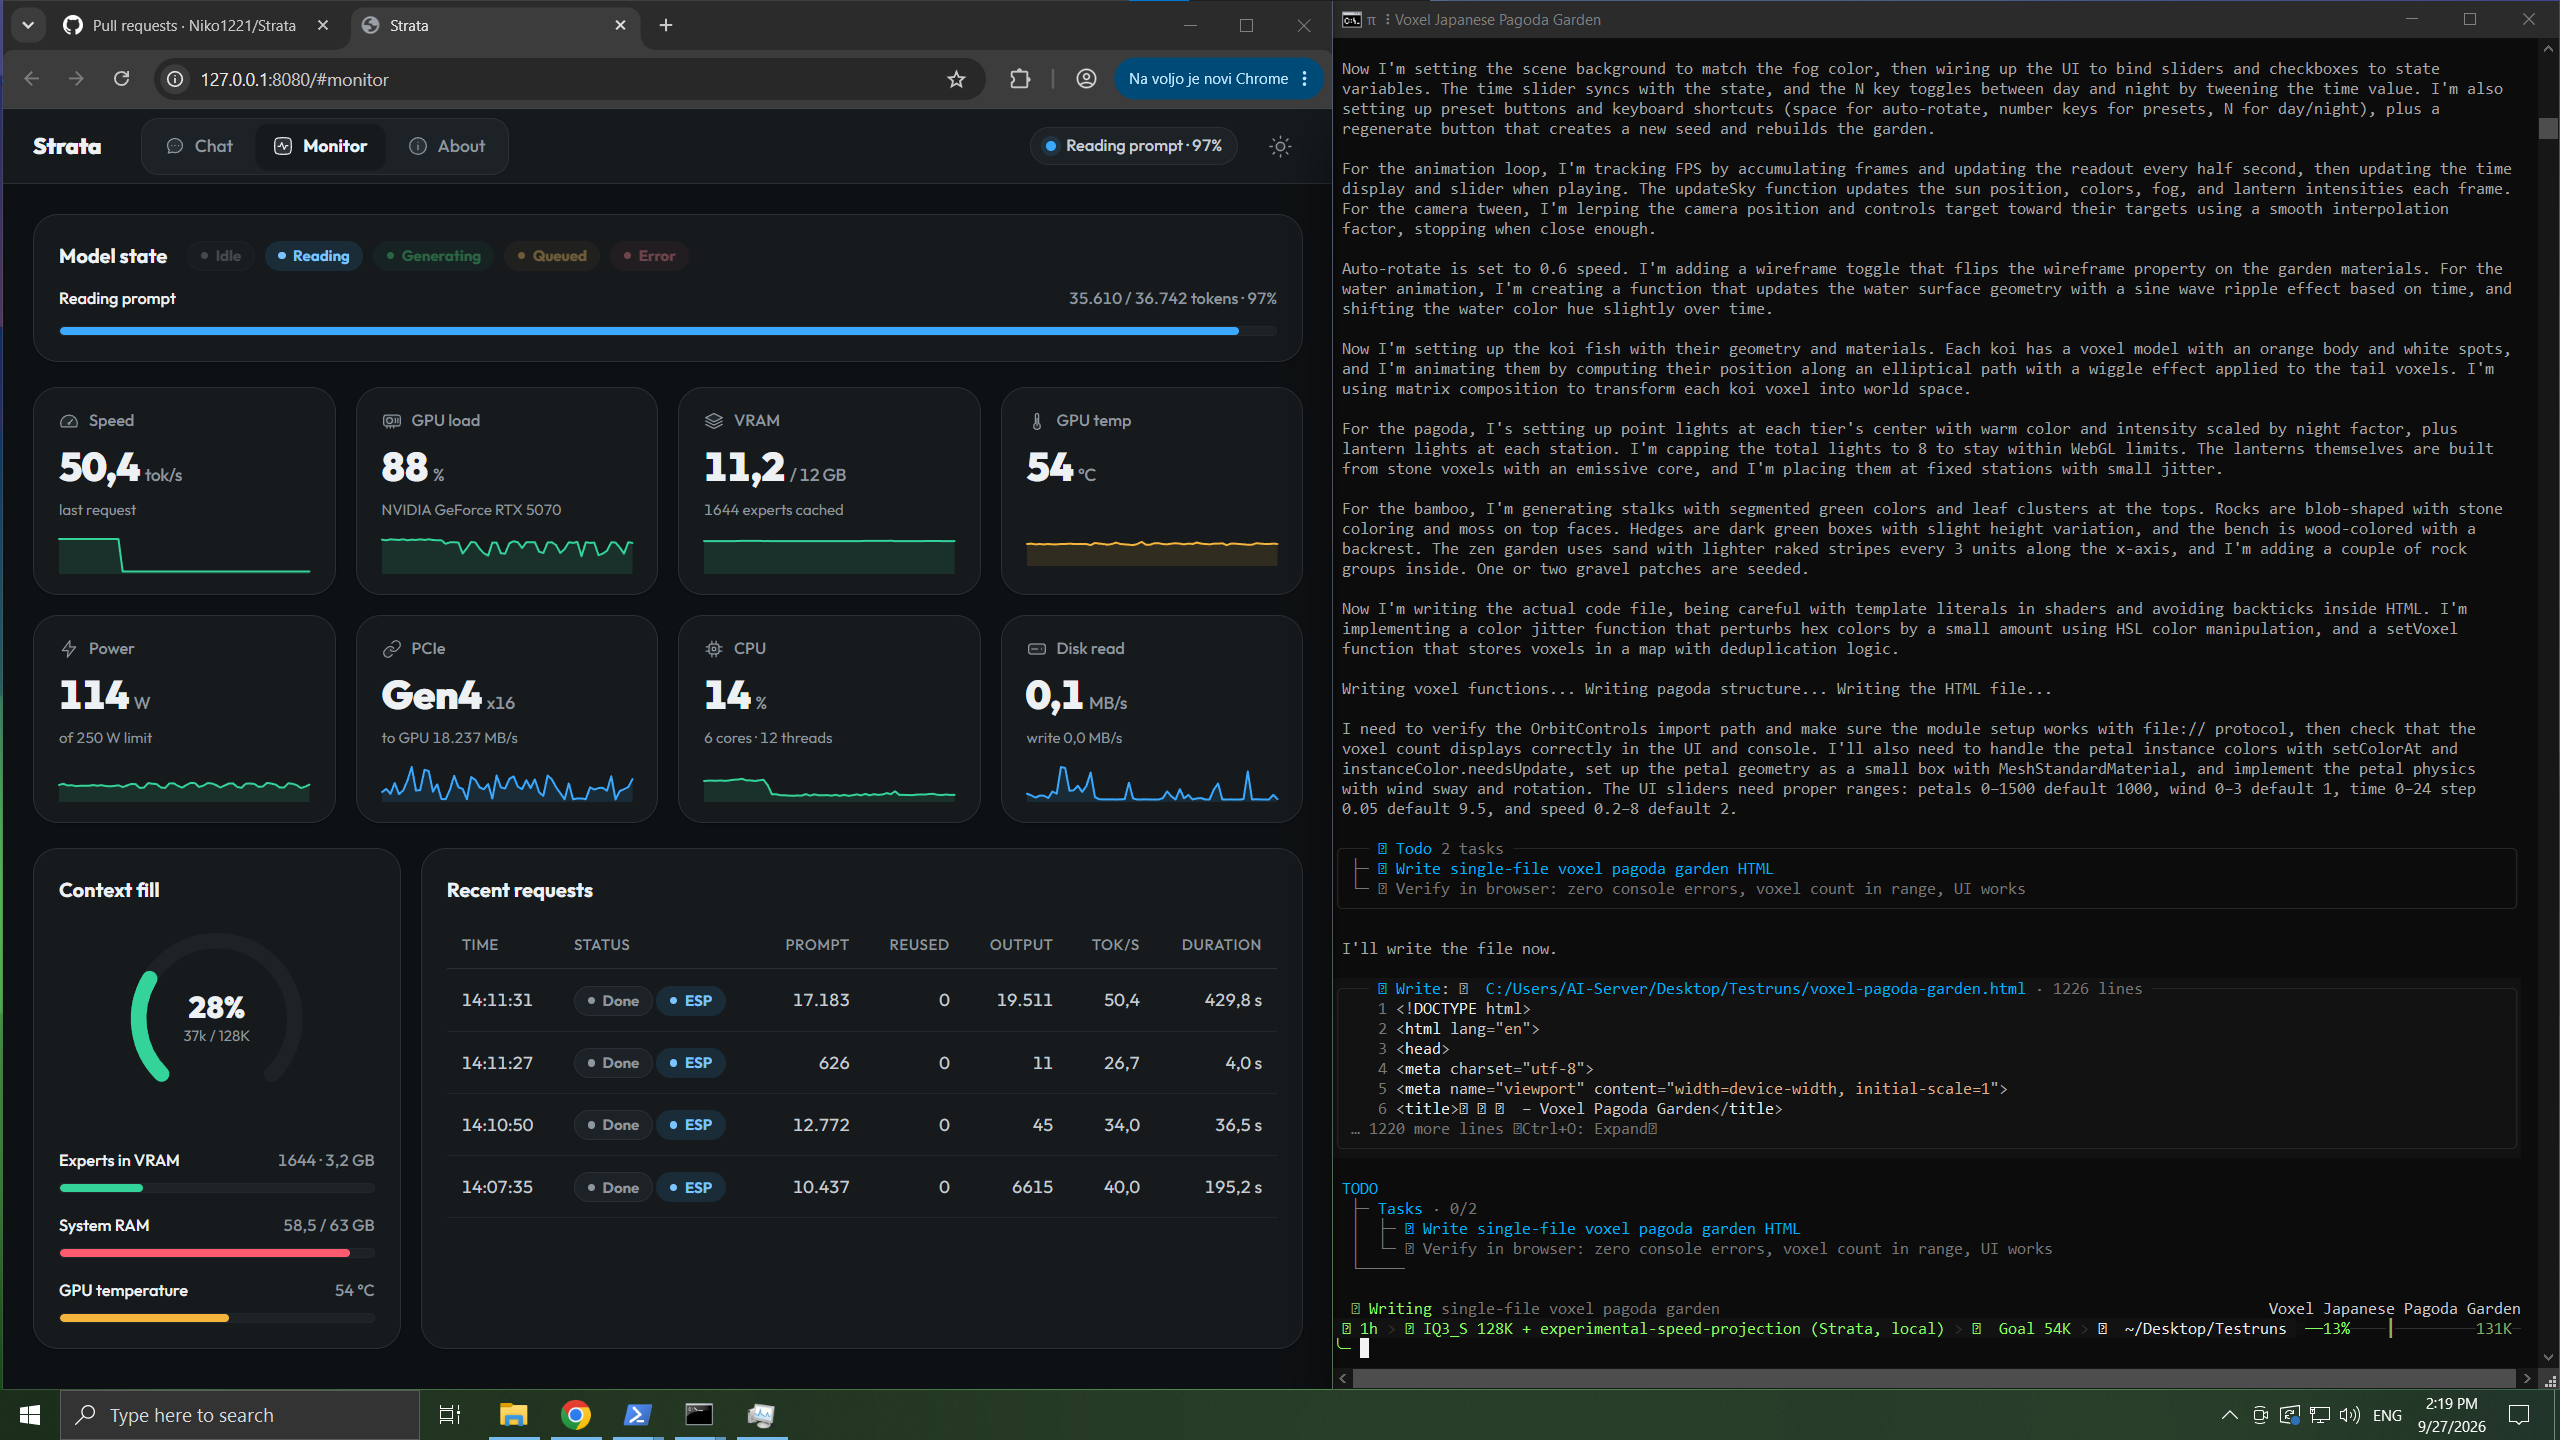
我使用的是一台几年前的 Windows 主机,部署的模型是 qwen3.8-flash-next-coder-iq1_m。在我的实际测试中,输出速度可以达到 20 多 tokens/s。这个数字会随量化版本、上下文长度、缓存状态和提示词变化,但体感上的变化非常明显:它已经可以进入正常对话和编码迭代的节奏。
项目 README 还公开了 RTX 5070 上 Coder 量化约 55 tokens/s、RX 9070 XT 上约 44 tokens/s 的测量结果。它们不是所有电脑的保证,但说明本地运行大模型已经不只是一台机器的偶然实验。
第一个真实测试:它会不会认真写正则?
我先让模型写一个 QQ 邮箱匹配的正则表达式。它不仅给出表达式,还解释开头不能为 0、数字长度、域名后缀和结尾锚点,并列出正确与错误示例。继续追问“只匹配纯数字 QQ 邮箱”时,它还能把表达式收敛成更短的版本。
第二个真实测试:从需求到 SQL
接着让它生成用户表的建表、查询、更新和删除 SQL。真正有用的不是会写一条语句,而是能否跟着需求把上下文补齐:从建表,到年龄条件查询,再到更新和删除指定记录。
从问答到协作:接入 OpenCode
当模型接入 OpenCode 之后,体验从“问答”变成“协作”:描述目标、拆任务、生成 HTML / CSS / JavaScript,再根据页面效果继续修改。我的测试中,模型配合 OpenCode 做出了一个完整网页的初版。
为什么它能跑起来?
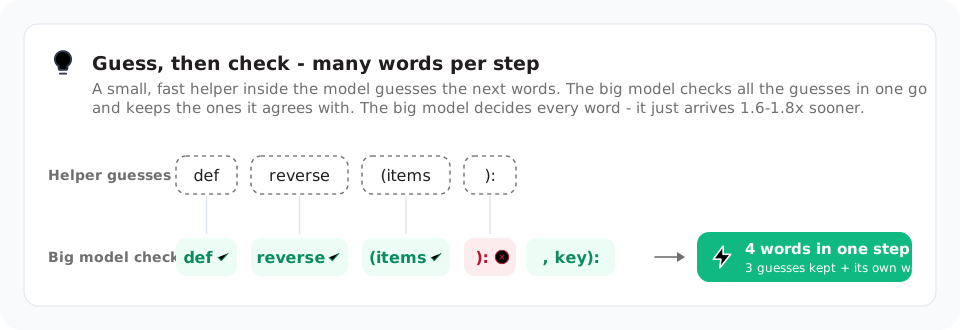
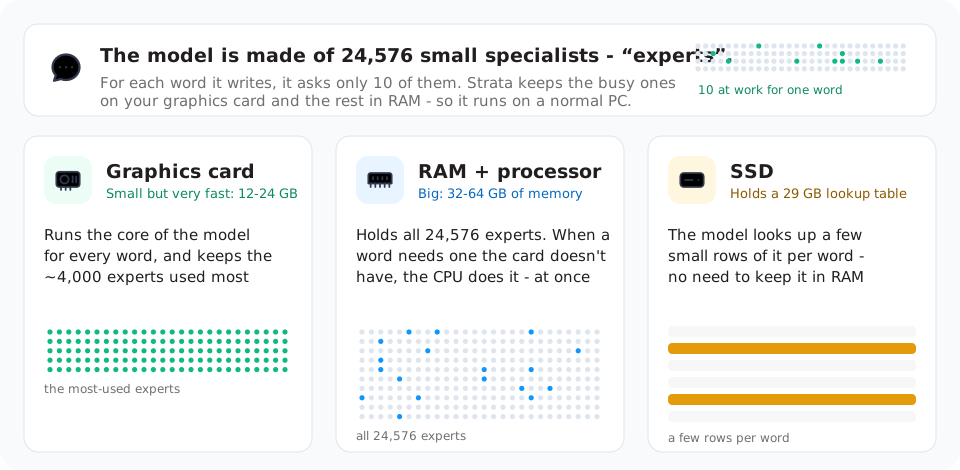
它并不是把整个模型完整塞进 12GB 显存,而是让整台电脑一起分工:GPU 放更需要低延迟的部分,系统内存承接更大的专家集合和上下文,SSD 作为模型文件和缓存仓库,再配合量化和调度降低资源压力。
现实边界:能用,不等于无条件好用
- 首次启动可能很慢,模型会占用大量内存。
- 量化版本会影响速度、质量和占用。
- 长上下文、KV 缓存、工具调用仍可能遇到工程边界。
- 局域网服务也要设置 API Key、限制监听地址并做好访问控制。
最终判断
如果你有一台类似配置的电脑,值得花一个晚上试试 Strata。别从“跑最大的模型”开始,也别急着追求参数规模。找一个你每天真的会做的任务:写代码、查文档、整理日志、生成页面。只要它能在你的任务上稳定省时间,本地 AI 就已经跨过了“能用”的门槛。
了解 Hana - 探索有趣的世界 的更多信息
订阅后即可通过电子邮件收到最新文章。


暂无评论