用 AI 写代码,有时候最让人着急的,还真不是它不会写。
而是它太能说。
让它修一个报错,先解释排查思路;改完几行代码,再介绍修改过程;最后还要来一段总结。看完一屏文字,真正想知道的无非三件事:问题在哪,改了什么,验证过没有?
如果你也希望 AI 干活时说得直接一点,可以看看这个项目:Caveman。
截至 2026 年 11 月 15 日,它在 GitHub 上约有 12 万 Star。名字翻译过来是“原始人”,点子也很有意思:让 AI 少说几句话,减少不必要的 Token 消耗。项目地址
不过,“少说话”到底有没有效果?为了不把这篇文章写成照搬宣传页的介绍,我用两个新的 Codex 对话,做了一次小对比。
01|给 AI 装一个“有话直说”的模式
Caveman 最容易理解的部分,是一个控制回答风格的 Skill。
可以把 Skill 理解成给 AI 的一份工作规范。它不会给模型换个脑子,但会告诉模型:接下来按这些规则回答。
- 先说答案,再解释原因。
- 去掉寒暄、重复总结和没有信息量的过渡句。
- 一句话尽量只表达一件事。
- 保留必要的技术细节。
其中有条规则很关键:代码、命令、路径、数字和错误信息不能为了精简而乱改,否定和限制条件也不能丢。
比如“不要删除备份”,总不能压缩成“删除备份”。
虽然名字叫“原始人”,项目也没有要求 AI 故意说得结结巴巴。相反,它明确反对为了表演这个角色,额外加上奇怪的口头禅。能用正常短句说清楚,就用正常短句。查看原始规则
这个方向挺实用:修 Bug 时,很多人需要的确实是一份简明的处理结果。
02|我用两个 Codex 对话,做了一次小对比
这次测试没有安装完整版,也没有开启代理或自动选模型。
我创建了两个全新的 Codex 对话,提交同一段代码和同一份要求。其中一个使用默认回答方式,另一个在任务前加入 Caveman 项目的原始 Skill 规则。
所以,这次测试比较的是精简规则对回答的影响,不包含安装流程和完整版功能。
题目很简单:修复下面这个计算商品总价的函数。
function totalPrice(items) {
  return items.reduce((sum, item) => sum + item.price * item.quantity, 0);
}
要求有三个:传入 null 或 undefined 时返回 0;正常数组的计算结果不变;不要修改输入数组。同时说明问题原因和需要验证的边界情况。
默认对话给出的核心修复是:
return (items ?? []).reduce(
  (sum, item) => sum + item.price * item.quantity,
  0
);
加入 Caveman 规则后,给出的修复是:
if (items == null) return 0;
return items.reduce((sum, item) => sum + item.price * item.quantity, 0);
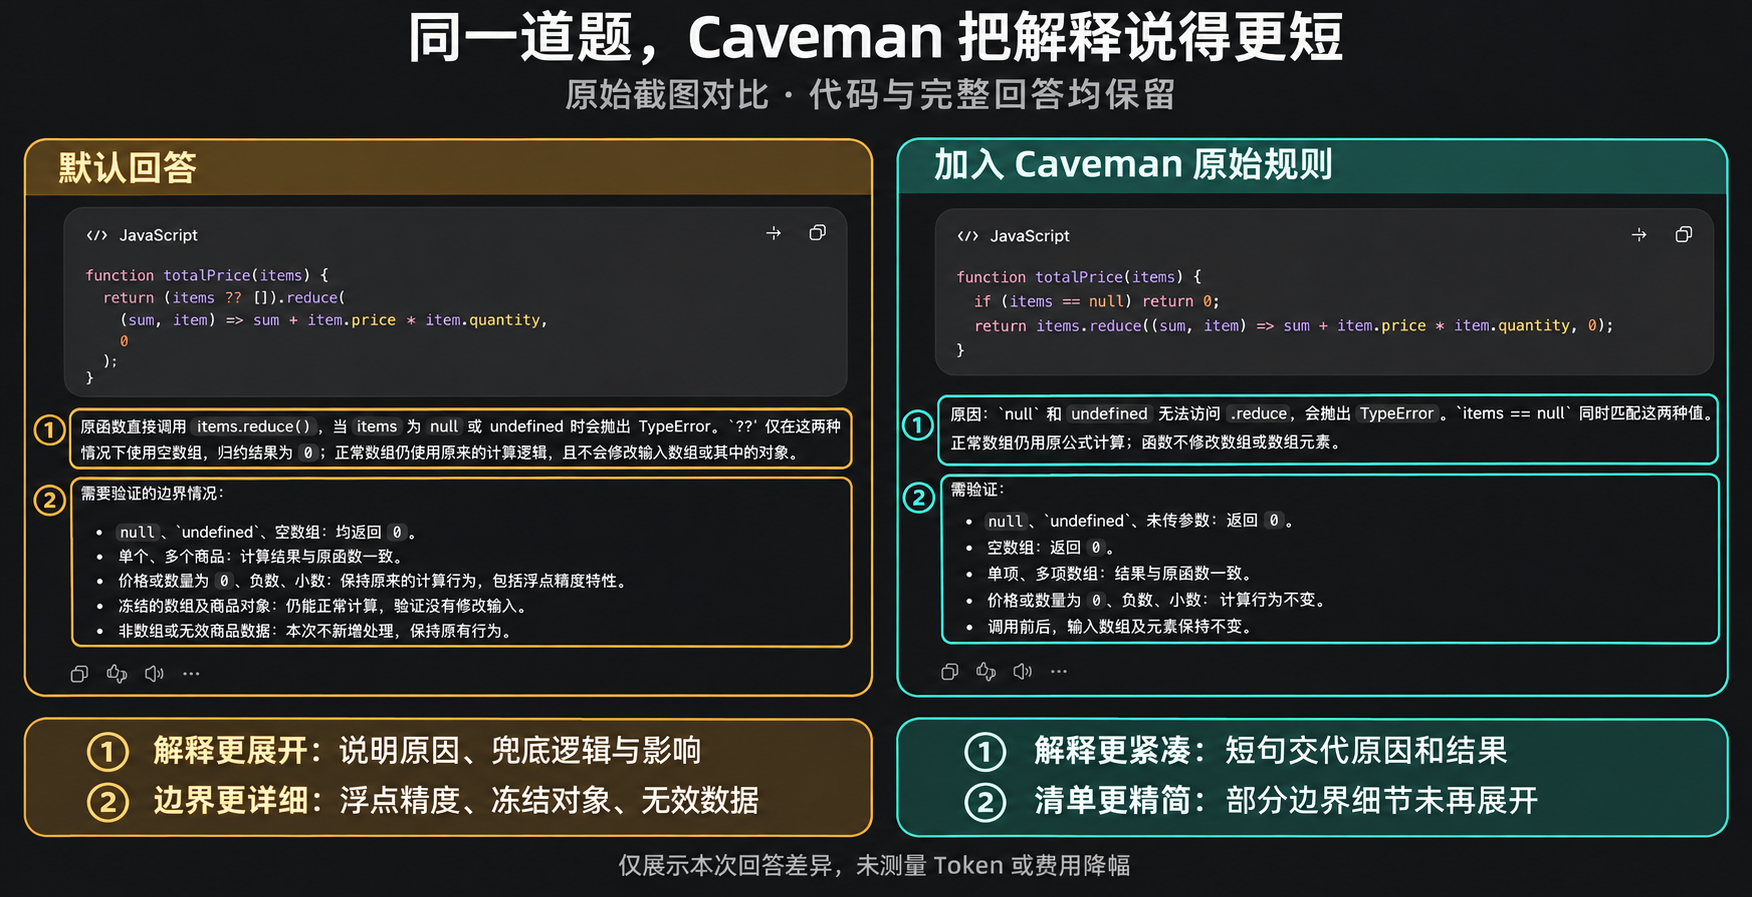
两种写法都能处理题目中的问题,只是选择了不同的实现。解释文字也有区别。
默认回答写道:
原函数直接调用 items.reduce(),当 items 为 null 或 undefined 时会抛出 TypeError。
随后继续说明空数组兜底、正常数组的行为,以及不会修改输入。
Caveman 版本则更直接:
原因:null 和 undefined 无法访问 .reduce,会抛出 TypeError。items == null 同时匹配这两种值。
接着补充:
正常数组仍用原公式计算;函数不修改数组或数组元素。
这次的真实结果,没有“长篇作文瞬间变一句话”那么夸张。默认 Codex 本身就回答得比较简洁,加入规则后,说明文字进一步收紧了。
两边都列出了需要检查的边界情况,不过清单并不完全相同。默认回答额外提到了无效数据和浮点精度,也明确提出用冻结的数组和对象检查输入是否被修改;Caveman 版本更短,省去了这些明确展开的细节。
我随后提取两边的实现,用 Node.js 检查了空值、空数组、多商品、零价格、负数、小数和冻结对象等情况。两种实现都通过了这次的 8 项检查。
这只能说明:在这道小题里,回答更短,没有影响这些已检查的结果。它不能证明复杂任务永远不丢信息,更不能直接换算成节省了多少费用。
03|现在的 Caveman,已经不只管“少说话”
继续看项目说明,会发现它已经从一个表达风格 Skill,扩展成一套减少 AI 编程消耗的工具。
首先是输入。AI 排查问题时,可能要读取很长的日志、大段 JSON、CSV 或测试输出。Caveman 可以压缩其中部分内容,减少交给模型读取的文字。
其次是模型选择。Auto 功能会根据任务选择模型和推理强度。简单问题尽量少花钱,复杂任务再投入更多计算。
还有重复工作。Blocks 功能尝试保留并复用脚本,减少助手每个会话重新编写相似脚本的情况。消耗分析功能则帮助查看 Token 主要花在哪里。
这些能力很容易混在一起,使用前要分清:只安装精简回答的 Skill,不会自动获得所有完整版功能。功能说明
04|“省 65%”,到底应该怎么看?
项目简介里的“减少 65% Token”很吸引人,但不能理解成装上之后,所有任务的账单都会少掉 65%。
一段解释文字变短、模型读取的内容减少、整个编程任务费用下降,是不同的指标。
尤其是写代码时,消耗不只有最后那几段回复,还有文件内容、工具调用、生成的代码和多轮上下文。
README 里有一组很值得看的对比:针对十个开发问题,除了默认回答,还加入了“请简洁回答”这个基线。
项目报告,相比这个基线,普通 Caveman 模式额外减少输出 Token 的中位数约为 3%。它也注明,这组数据使用较早版本的规则,尚未重新测试;规则本身也会增加输入 Token。测试说明
如果你的助手原本很啰嗦,变化可能比较明显;如果它已经很简洁,继续压缩的空间就有限。使用按请求次数计费的服务时,回答变短也未必让账单下降。
这次我的小测试也没有测量完整 Token 消耗,因此不报“亲测省了多少”的数字。
05|想体验,先装 Skill 就够了
如果你主要想解决“AI 回答太长”的问题,可以先从轻量的 Skill 开始。
电脑上有可用的 Node.js 和 npm 环境后,在终端执行:
npx skills add JuliusBrussee/caveman -g按提示选择使用的工具和需要安装的 Skill。安装完成后,新开一个会话。
在 Codex 中可以这样调用:
$caveman 帮我检查这段代码,指出问题并给出修改建议。在 Claude Code 等支持相应命令的工具里,使用:
/caveman想恢复正常表达,输入:
stop caveman以上是项目提供的使用方法。这次文章中的对比采用了直接加载原始规则的方式,没有实际走完这条安装流程。安装与启用说明
06|哪些时候,我会考虑用它?
如果任务是修一个报错、检查一处修改、看测试结果,简短回复通常更方便。
但如果是在学习陌生代码、理解一个架构设计,或者比较几种方案,我还是希望助手把原因讲充分。多解释几句,有时候正是我需要的东西。
另外,准备使用完整版时,可以先看一眼隐私说明:CLI 默认发送使用统计,可以关闭;登录并选择 Auto 后,会向 Caveman Cloud 发送用于路由判断的部分对话上下文。它和单独使用表达规则的 Skill,涉及的数据范围不同。隐私说明
这次看完规则、跑完小测试,我觉得 Caveman 最容易感受到的价值,是让回复更方便扫读。
任务做完,直接告诉我改了哪里、为什么这样改、哪些检查通过了、还有什么没验证。
需要解释的时候再展开。平时这样说话,就挺好。
了解 Hana - 探索有趣的世界 的更多信息
订阅后即可通过电子邮件收到最新文章。



暂无评论